Python · Machine Learning · Deep Learning
Détection Pierre-Papier-Ciseaux
Collection de projets du cours Python été 2026, couvrant les bases de la syntaxe Python, la prédiction par régression en Machine Learning, l'analyse des données de comportement étudiant, et la reconnaissance de gestes Pierre-Papier-Ciseaux basée sur YOLO11n.
Le projet en bref
Cette page documente un parcours de cours allant des bases de Python à la vision par ordinateur, en quatre étapes : 14 exercices de syntaxe, une régression par forêt aléatoire sur les prix immobiliers californiens, l’analyse de données sur le comportement numérique des élèves, et un détecteur de gestes à trois classes entraîné avec YOLO11n. Le modèle atteint un mAP50 de 0,940 sur l’ensemble de validation, la page listant le jeu de données, la configuration d’entraînement et les résultats d’évaluation.
- Progression structuréeBases de programmation, analyse de données structurées et détection visuelle forment une chaîne d’apprentissage continue.
- Tâches de données interprétablesLes analyses immobilière et comportementale fournissent l’importance des variables et des comparaisons de modèles.
- Démonstration en directLe détecteur pierre-feuille-ciseaux est présenté avec une animation et des métriques de validation.
À propos de ce projet
Ce qu’il traite
Un travail de cours s’arrête souvent à un exemple d’algorithme unique. Ce projet enchaîne les bases de Python, l’apprentissage automatique classique et la détection par apprentissage profond en un parcours unique, avec des données, du code et des résultats complets à chaque étape.
Contenu des quatre étapes
La première étape couvre 14 exercices de syntaxe Python ; la deuxième applique une forêt aléatoire à la régression sur le jeu de données immobilier californien ; la troisième analyse les données de comportement numérique des élèves et produit six types de graphiques ; la quatrième entraîne YOLO11n à détecter les gestes pierre, feuille et ciseaux.
Ce qu’il utilise
Python est le langage principal, avec la forêt aléatoire de scikit-learn pour l’analyse et la modélisation. L’étape de vision utilise YOLO11n avec 2,58 M de paramètres, entraîné sur une RTX 5060.
Résultats et lecture
Le modèle de détection de gestes atteint un mAP50 de 0,940 sur l’ensemble de validation ; la page liste la taille du jeu de données, l’augmentation et la configuration d’entraînement. Le reproduire exige le code du cours, l’environnement de dépendances et les poids du modèle.
Project 1
Exercices de base Python
14 exercices d'introduction : types de données, contrôle de flux, fonctions, listes et dictionnaires — couverture complète des bases syntaxiques.
Project 2-1
Prédiction des prix immobiliers
Régression par Random Forest pour prédire le prix médian des logements en Californie, R² = 0,805. Confirmation que le revenu et la localisation géographique sont les facteurs d'influence clés.
Project 2-2
Analyse du comportement étudiant
Jeu de données réel Kaggle, analyse de l'impact du temps d'étude et du temps d'écran sur le CGPA, comparaison multi-modèles.
Project 3
Reconnaissance de gestes YOLO11n
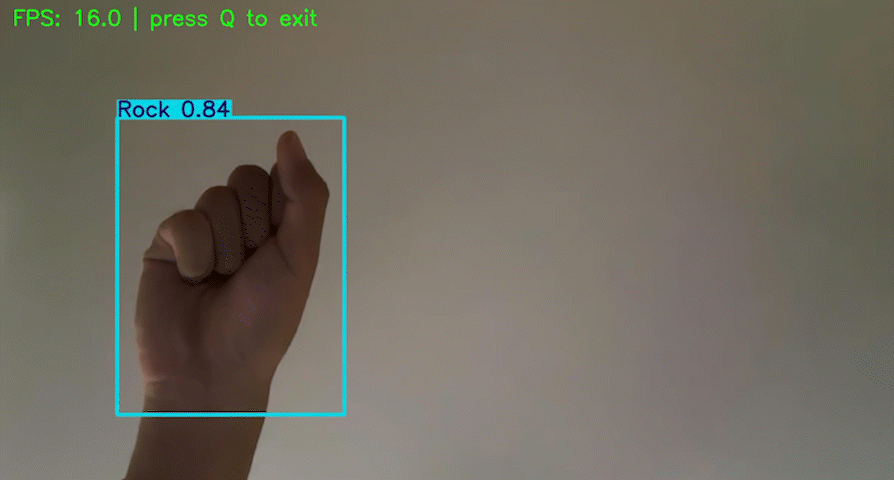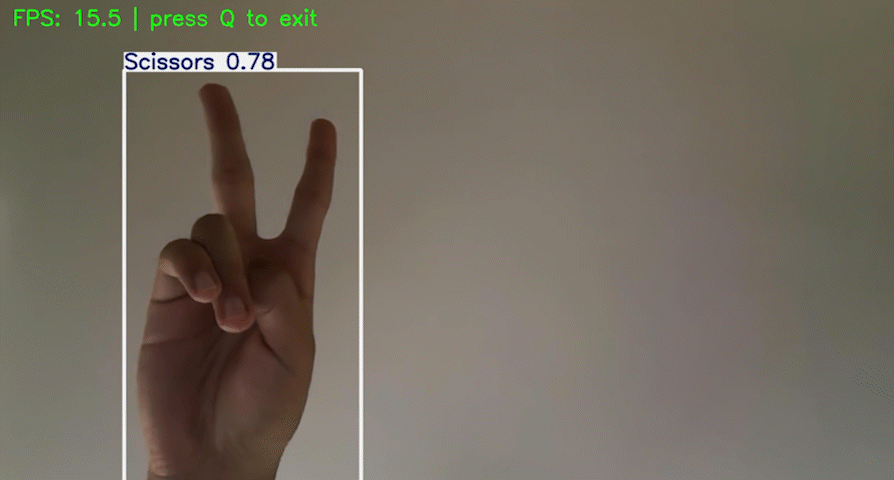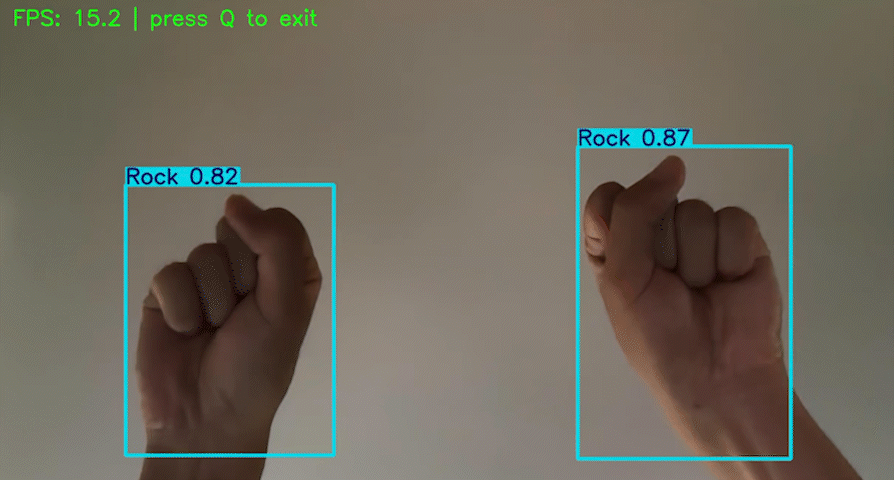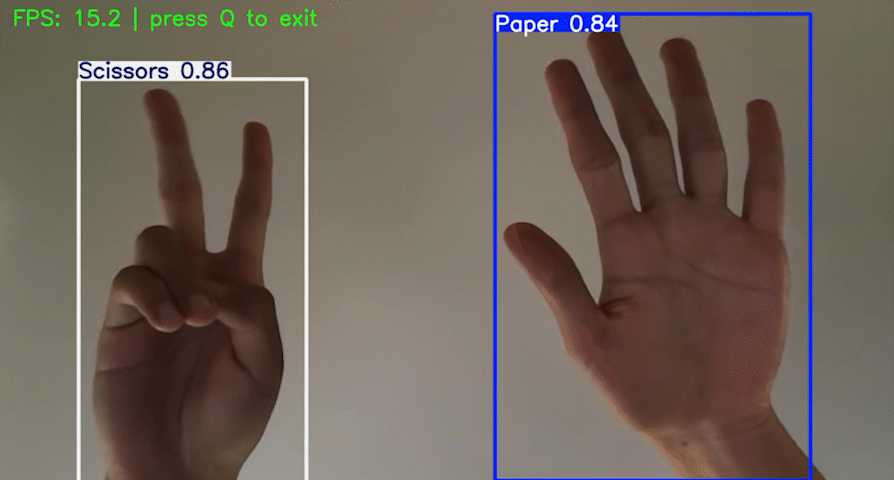
🪨📄✂️ Détection en temps réel de Ciseaux/Pierre/Feuille, mAP50 sur l'ensemble de validation = 0,940, inférence à l'échelle de la milliseconde.
Types de données
1.1.py — Carré d'un entier positif1.2.py — Sortie formatée des informations d'admission1.3.py — Longueur de l'hypoténuse d'un triangle rectangle
Opérateurs & expressions
2.1.py — Distance euclidienne entre deux points2.2.py — Somme des cubes des chiffres d'un nombre à trois chiffres2.3.py — Nombre d'occurrences d'une lettre (insensible à la casse)
Contrôle de flux & fonctions
3.1-3.2 — Niveau de note / Type de caractère4.1-4.2 — Détermination du nombre de chiffres / Somme factorielle5.1-5.2 — Encapsulation de fonctions et calculs mathématiques6.1-6.2 — Compréhensions de liste / Mappage de dictionnaire
Jeu de données
California Housing — Jeu de données intégré à scikit-learn
- Taille de l'échantillon : 20 640 enregistrements de quartiers
- Nombre de caractéristiques : 8 (revenu médian, âge du logement, nombre de pièces, population, localisation géographique, etc.)
- Cible : MedHouseVal (prix médian du logement, $100K)
Évaluation du modèle
MSE
0.2552
RMSE
0.5052
R²
0.8053
Top 4 de l'importance des caractéristiques
MedInc (revenu médian) > AveOccup (occupation moyenne) > Latitude / Longitude (localisation géographique) > HouseAge
Le niveau de revenu est le facteur prédictif le plus fort pour les prix immobiliers ; l'importance de la localisation reflète les écarts de prix entre différentes régions de Californie.
Python
scikit-learn
Random Forest
Pandas
Matplotlib
Jeu de données
Student Lifestyle and Academic Performance (Kaggle)
- 12 champs : Age, Branch, Study_Hours, Sleep_Hours, Screen_Time, Gym, Diet, Attendance, Stress, Residence, Internal_Marks, CGPA
- Variable cible : CGPA (moyenne cumulative, 0~10)
- Exclusion de Internal_Marks pour éviter les fuites de données
Processus de nettoyage des données
- Sélection des champs → Déduplication
- Champs numériques : imputation par la médiane des valeurs manquantes
- Champs catégoriels : imputation par le mode
- Filtrage des valeurs aberrantes (plages raisonnables pour l'âge, le temps d'étude, etc.)
- Variables catégorielles : encodage one-hot (drop_first)
Distribution du temps d'écran
Distribution asymétrique à droite, la majorité des étudiants passent 3~8 heures par jour devant un écran
Temps d'étude vs CGPA
Corrélation positive claire, les étudiants étudiant 6~8 h/jour ont généralement un CGPA plus élevé
Top 3 de l'importance des caractéristiques
Temps d'étude > Taux d'assiduité > Temps d'écran
Python
Linear Regression
Random Forest
Pandas
Seaborn
EDA
Jeu de données
rock-paper-scissors-sxsw (Roboflow v11)
- Total de 15 874 images
- Ensemble d'entraînement 14 966 / Validation 588 / Test 320
- 3 classes : Paper (Feuille), Rock (Pierre), Scissors (Ciseaux)
- Taille d'entrée : 640×640
Augmentation des données
Génération de 7 versions augmentées par image originale :
- Retournement horizontal (50%), rotation aléatoire ±12°
- Cisaillement ±2°, luminosité/exposition ±25%
- Flou gaussien 0~1,5 px, bruit poivre-et-sel 1%
Configuration d'entraînement
ModèleYOLO11n (2.58M params)
Epochs50
Batch16
OptimiseurAdamW
Durée d'entraînement~3.07h
GPURTX 5060 (8GB)
Ensemble de validation
mAP50 (global)
0.940
mAP50-95
0.697
Précision (P)
0.942
Rappel (R)
0.891
Vitesse d'inférence
< 2.1ms
Ensemble de test
mAP50 (global)
0.934
mAP50-95
0.693
Précision (P)
0.898
Rappel (R)
0.920
Performance par classe
📄 Paper
Validation mAP500.936
Test mAP500.904
🪨 Rock
Validation mAP500.943
Test mAP500.951
✂️ Scissors
Validation mAP500.940
Test mAP500.947
Inférence sur image unique
Reconnaissance sur n'importe quelle photo de geste, les résultats sont annotés sous forme de boîte englobante + étiquette, sauvegardés dans le répertoire de sortie.
predict.py
Détection en temps réel par caméra
Utilisation de la caméra système (1280×720) pour une capture en temps réel, inférence à l'échelle de la milliseconde par image, affichage du taux de trames FPS dans la fenêtre, appuyez sur Q pour quitter.
detect.py
Scripts d'évaluation
Évaluation sur l'ensemble de validation, évaluation sur l'ensemble de test, outil de téléchargement du jeu de données, couverture complète du flux d'entraînement au déploiement.
evaluate.py / test.py
Python
PyTorch
YOLO11n
Ultralytics
OpenCV
Roboflow
CUDA